Jeff
Millisecond decisions, any domain: a 0.8B open "System 1" model that picks between your options with calibrated probabilities. One base, swappable LoRA adapters, on your own hardware.
DOWNLOAD下载地址
-
站内直链 Jeff · 完整源码包 4.9 MB
-
站内直链 Jeff · 一键安装工具包(含 Windows 脚本) 10 KB windows,macos,linux
-
GitHub 发布 GitHub 仓库(查看源码 / 提交反馈)
站内直链无需提取码,点击即可下载。
INTRO项目介绍
这是什么
Jeff 是一个只有 0.8B 参数的「系统 1」决策模型:你把情况和若干个选项用大白话写给它,它在一次前向传播里给每个选项返回一个校准过的概率。不生成文字,不需要解析输出,有独显时 22 毫秒就能给出一次决策。
它不跟你聊天,也不是用来写文章或做多步推理的。它的位置在大模型前面——让 Qwen3.8-27B 这类大模型去写作和规划,让 Jeff 先把那些高频、简单、要快的判断做掉:Jeff 先答,只有当它没有把握时,请求才继续交给后面的大模型。
它解决什么问题
小模型做判断有两个老毛病:不准、而且「不知道自己不准」(概率不可信)。Jeff 用两条办法压住:
- 校准概率:每个选项给一个概率值,并且这个值经过温度拟合,说 90% 就是真的 90% 左右——所以你可以放心用「置信度低于阈值就转交大模型」这个策略。
- LoRA 适配器:每个适配器约 41 MB,针对一个具体任务微调。官方提供了 9 个,也可以自己训。
官方给出的对比(同一个 27B 模型,加不加 Jeff 的差别):
- 准确率:8 个适配器平均 86.6% → 95.3%
- 每次决策耗时:8.1 秒 → 0.25 秒(快 38 倍)
- 错误率:13.4% → 4.7%(错误少 2.8 倍)
- 显存:27B 占 28.6 GB,Jeff 九个适配器全加载只多 1.96 GB
九个官方适配器
每个适配器管一件事,用哪个加载哪个(不指定适配器就走未经微调的基座零样本模式):
- guard — 提示注入与越狱拦截,98.4%
- spam — 短信与邮件垃圾/钓鱼识别,98.4%
- tools — Agent 该调用哪个工具,97.9%
- nav — 语音指令对应屏幕上哪个元素,97.0%
- ground — 答案有没有被原文支持(重排 + 接地),97.0%
- support-intents — 客户到底想要什么,96.8%
- triage — 工单紧急度与情绪,91.8%
- legal-clauses — 合同条款类型,85.7%
- emotion — 短评论里 27 种情绪里最强的一种,60.6%(这题人类标注都不一致,27B 只有 35.6%)
资源占用与硬件
- 权重体积:0.8B 模型 16 位约 1.7 GB
- NVIDIA RTX PRO 6000:每次决策约 22 毫秒;加载全部九个适配器、每次请求都切换适配器,中位数 30 毫秒、显存 1.96 GB
- Apple M4 Max(MLX 后端):约 28 毫秒
- 纯 CPU(32 线程):463 毫秒——能跑,但慢一个量级
也就是说:有独显最好,Mac 的 Apple 芯片也可以,纯 CPU 也能用,只是别指望毫秒级。
怎么用
它对外是一个本地 HTTP 服务(默认 127.0.0.1:8000,可用 PORT 改),三个接口:
GET /health— 健康检查GET /v1/models— 当前可用的模型与适配器列表POST /v1/systemone— 发一次决策请求
官方提供了 Python 客户端和 TypeScript 客户端,Python 侧用法大致是这样(先起服务,再调用):
from jeff import Client
from jeff.client import choice_question, yes_no_question

jeff = Client("http://localhost:8765", model="jeff-latest")
answers = jeff.ask("包裹到的时候已经压坏了,我要退款。", {
    "team": choice_question({"refunds": "退款与支付", "parcels": "包裹破损或丢失",
                             "login": "账号与登录问题"}, "这单该谁来处理?"),
    "angry": yes_no_question("客户生气了吗?"),
})
answers.choice("team").key # "parcels",同时带概率三类问题:choice(最多 254 个选项)、yes_no、score(打分)。两条必须遵守的规矩:选项的 key 永远不要用纯数字;请求里不变的部分放前面、变化的部分放最后。
用之前要知道的
- 适配器绑定基座版本:v1.2 的适配器只能用在 Jeff-Qwen3.5-0.8B v1.2 上,换成别的基座服务端会直接拒绝。换基座版本需要重训适配器,但数据集可以沿用。
- 小模型不会推理:它是在你给的选项之间做快速校准的选择,不是用来做多步推理的。
- 只支持英文文本,选项上限 254 个(另一个 Gemma 版基座只支持 26 个)。
- 它是个分类器,不是规划器:把「每个选项意味着什么」在代码里想清楚,不要让它去预测。
授权的坑(重要)
这个项目的代码是 MIT、模型权重是 Apache 2.0,可以商用。但注意仓库首页的「Licence」一节写得很清楚:他们只公开权重和代码,不公开训练数据;训练数据里有一部分来源是 CC BY-SA 等分享相同的协议。
谁适合用
- 想给本地大模型加一层快速前置判断、省掉大量「杀鸡用牛刀」的调用
- 做 Agent、客服、内容审核、语音交互,需要毫秒级且概率可信的分类
- 想学 LoRA 微调:仓库自带 adapter kit(训练前查数据有没有「捷径特征」)和完整的训练脚本,40 分钟到 4 小时能训出一个适配器
- 只想在自己的机器上跑、不想把数据发给任何云服务
GUIDE安装与使用教程
这篇教程带你在一台普通电脑上把 Jeff 装起来并跑通。全文步骤都在真实环境里跑过一遍,截图是真实终端输出,不是照着 README 抄的。
开始之前
系统要求:
- Windows 10/11、macOS、或 Linux 都行
- Python 3.12 或更高(这是硬要求,比多数项目严格)
- 硬盘留 8 GB 以上(Python 依赖约 3 GB,模型权重 1.7 GB)
- 装适配器训练才需要 NVIDIA 显卡;只做推理,纯 CPU 也能跑
硬件建议: 有 NVIDIA 独显最快(每次决策约 22 毫秒);Apple 芯片的 Mac 用 MLX 后端约 28 毫秒;纯 CPU 大概 463 毫秒一次,能用但慢一个量级。
第 1 步 · 确认 Python 版本
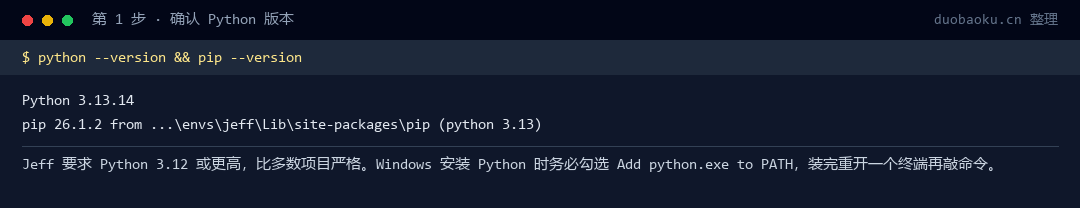
打开终端(Windows 用 PowerShell 或 CMD),敲:
python --version
pip --version
看到 3.12 以上才能继续。如果提示找不到 python,说明装 Python 时没勾「Add python.exe to PATH」,重装一遍并勾上,然后重开一个终端。
第 2 步 · 千万不要 `pip install jeff`
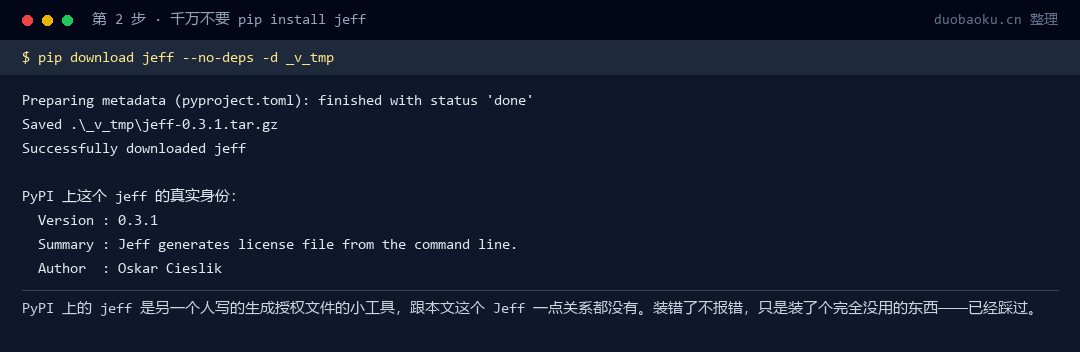
这一步是本文最想提醒你的地方。PyPI 上确实有一个叫 jeff 的包,但它跟本文的 Jeff 毫无关系 —— 那是另一个人写的、用来生成授权文件的小工具(0.3.1 版,作者 Oskar Cieslik)。
如果你手快敲了 pip install jeff,不会报错,只会装上一个完全没用的东西,然后奇怪为什么 jeff-serve 命令不存在。
正确做法只有一个:从源码安装,往下看。
第 3 步 · 建一个独立环境
不动系统里的 Python,单独开一个环境给 Jeff:
python -m venv jeff-envWindows 激活:
jeff-env\Scripts\activatemacOS / Linux 激活:
source jeff-env/bin/activate激活成功后命令行前面会出现 (jeff-env)。
第 4 步 · 装依赖(版本号别改)
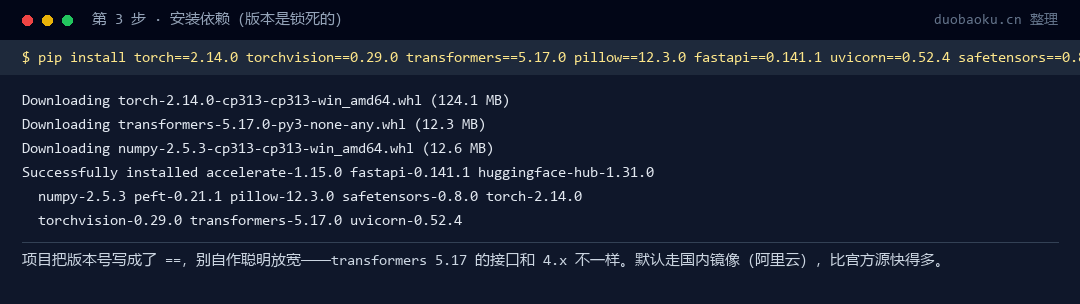
Jeff 的依赖表把版本号全部写死了,照着装就行:
pip install torch==2.14.0 torchvision==0.29.0 transformers==5.17.0 pillow==12.3.0 fastapi==0.141.1 uvicorn==0.52.4 safetensors==0.8.0 numpy==2.5.3 huggingface-hub==1.31.0 peft==0.21.1为什么要锁版本: transformers 5.x 的接口和 4.x 是两回事,放宽版本限制极可能装上一个对不上的版本,然后在莫名其妙的地方报错。
国内网络慢的话加个镜像(实测阿里云可用):
pip install -i https://mirrors.aliyun.com/pypi/simple/ torch==2.14.0 ...(后面同上)一共约 3 GB,耐心等它下载完。
第 5 步 · 装上 Jeff 本体
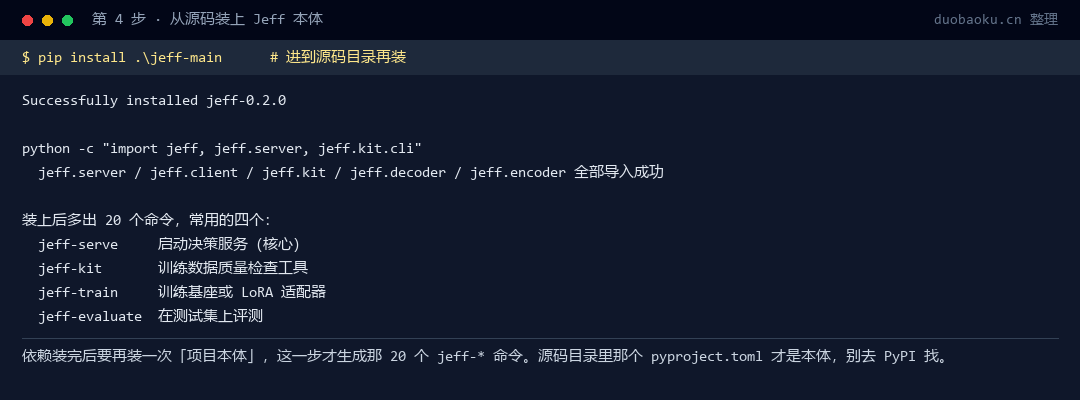
依赖装完只是装了「零件」,还得把项目本身装上。进到源码目录(解压出来那个 jeff-main),执行:
pip install .这一步才生成那 **20 个 jeff-* 命令**。常用的四个:
jeff-serve—— 启动决策服务(核心)jeff-kit—— 训练数据质量检查工具jeff-train—— 训练基座或 LoRA 适配器jeff-evaluate—— 在测试集上评测
验证一下装没装上:
python -c "import jeff, jeff.server, jeff.kit.cli; print('OK')"第 6 步 · 用 jeff-kit 检查你的训练数据
这一步不需要模型权重,装上就能用,也是这个项目里最实用的工具。
Jeff 的适配器好不好,几乎全看训练数据。而数据里最坑的问题是捷径特征:某个表面特征(比如文本长度)恰好能区分标签,模型学会它之后,在你自建的测试集上分数很高,一到真实输入就崩。官方说他们做九个适配器,每一个都至少栽过一次。
jeff-kit 就是用来提前把这些问题查出来的。它自带一份 60 行的样例数据,可以拿它先熟悉流程。
① 检查每一行是否合法:
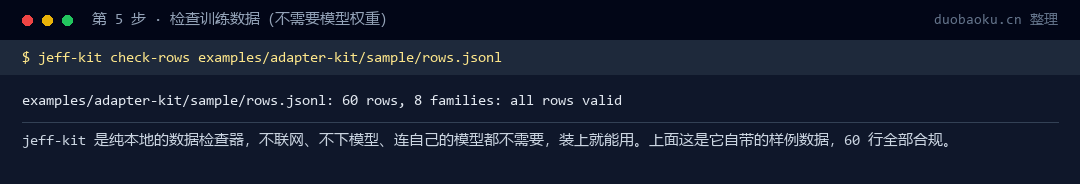
jeff-kit check-rows examples/adapter-kit/sample/rows.jsonl输出 60 rows, 8 families: all rows valid 就是全部合规。它会挑出的毛病包括:字段缺失、标签不在选项里、选项 key 用了纯数字(JavaScript 会静默重排)、同一个 id 出现两次、模板占位符 ${...} 忘了替换。
② 按「组」切分数据:
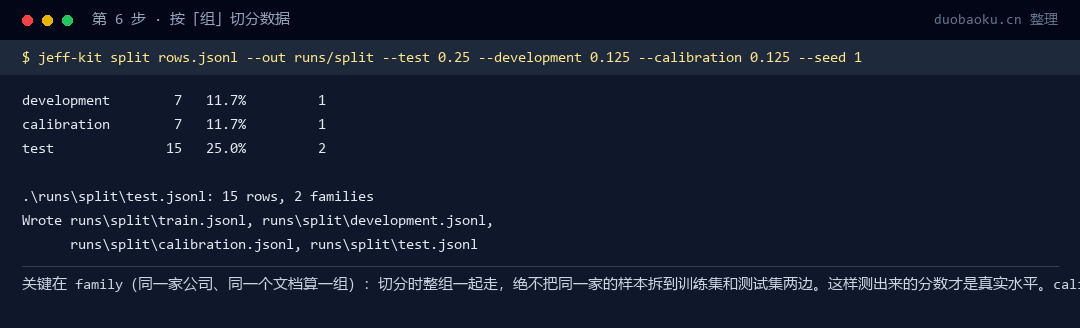
jeff-kit split examples/adapter-kit/sample/rows.jsonl --out runs/split --test 0.25 --development 0.125 --calibration 0.125 --seed 1关键在于 family(组):同一家公司、同一个文档的样本算一组,切分时整组一起走,绝不把同一家的样本拆到训练集和测试集两边。这样测出来的分数才是真实水平。
切出来四份,各有用处:train 训练用、development 选检查点、calibration 专门用来拟合温度、让概率可信、test 测试用。
③ 查数据泄漏:
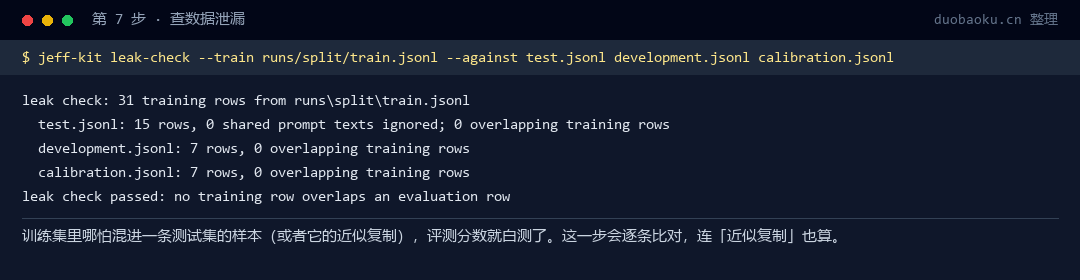
jeff-kit leak-check --train runs/split/train.jsonl --against runs/split/test.jsonl runs/split/development.jsonl runs/split/calibration.jsonl训练集里哪怕混进一条测试样本(或它的近似复制),评测分数就白测了。
④ 查捷径特征:
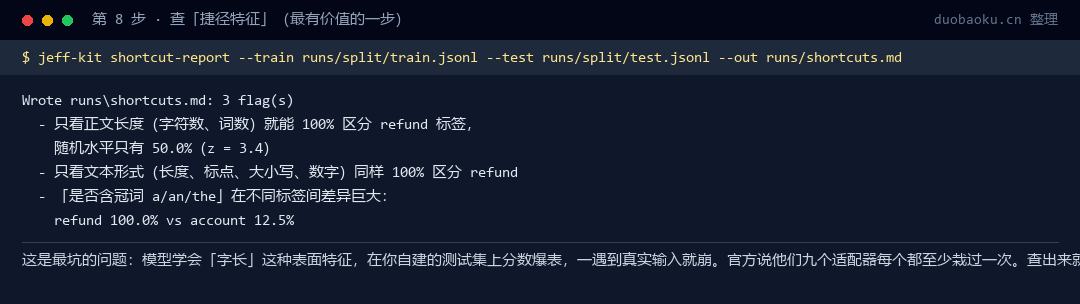
jeff-kit shortcut-report --train runs/split/train.jsonl --test runs/split/test.jsonl --out runs/shortcuts.md拿它自带的样例数据跑,工具报出 3 个问题。最典型的一条:只看正文长度就能 100% 区分 refund 标签(随机水平只有 50%)。这种数据拿去训练,模型学的就是「字数」而不是「意思」。
看到这类警告,回头改数据,别硬训。
第 7 步 · 跑一遍官方测试(可选)
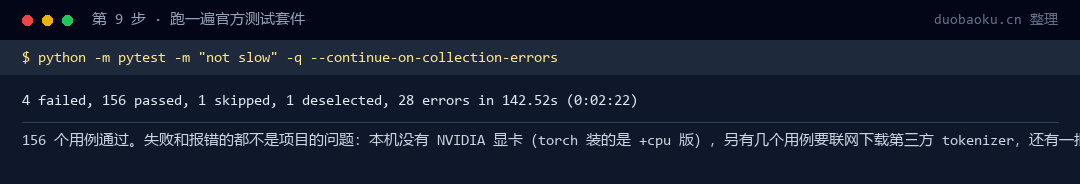
python -m pytest -m "not slow" -q --continue-on-collection-errors本机实测:156 个通过。剩下的失败和报错都不是项目的问题,见下面「兼容性说明」。
第 8 步 · 下载模型权重
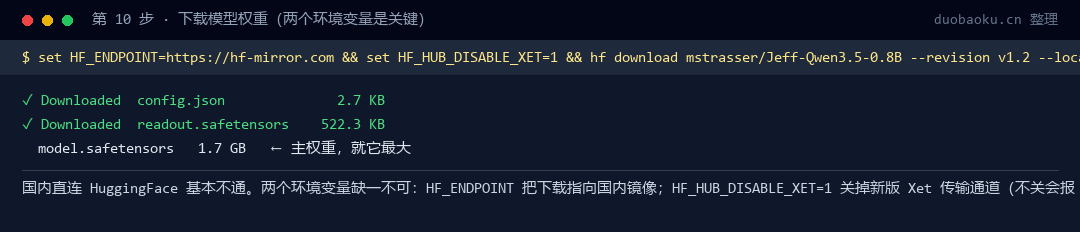
服务要跑起来,必须有模型权重(1.7 GB)。国内直连 HuggingFace 基本不通,用国内镜像:
Windows:
set HF_ENDPOINT=https://hf-mirror.com
set HF_HUB_DISABLE_XET=1
hf download mstrasser/Jeff-Qwen3.5-0.8B --revision v1.2 --local-dir Jeff-Qwen3.5-0.8B-v1.2
macOS / Linux:
export HF_ENDPOINT=https://hf-mirror.com
export HF_HUB_DISABLE_XET=1
hf download mstrasser/Jeff-Qwen3.5-0.8B --revision v1.2 --local-dir Jeff-Qwen3.5-0.8B-v1.2
两个环境变量缺一不可:
HF_ENDPOINT把下载指向国内镜像(不设就是连 huggingface.co,大概率超时)HF_HUB_DISABLE_XET=1关掉新版 Xet 传输通道。不关会直接报401 Unauthorized(错误信息指向cas-server.xethub.hf.co,看起来像权限问题,其实是通道不通,极容易误判)
镜像偶尔抽风连接超时,客户端会自己重试,看到 Retrying in 1s [Retry 1/5] 属正常,别急着按 Ctrl+C。
想连适配器一起下(每个约 41 MB,按需选):
hf download mstrasser/Jeff-Qwen3.5-0.8B-guard --local-dir adapters/guard可选的适配器名有:guard triage support-intents tools ground nav emotion spam legal-clauses。
第 9 步 · 启动决策服务
Windows:
set JEFF_CHECKPOINT=Jeff-Qwen3.5-0.8B-v1.2
set JEFF_ADAPTERS=adapters
set PORT=8765
jeff-serve
macOS / Linux 把 set 换成 export,Apple 芯片再加一句 set JEFF_BACKEND=mlx。
服务跑起来后,浏览器打开 http://127.0.0.1:8765/health 能看状态。
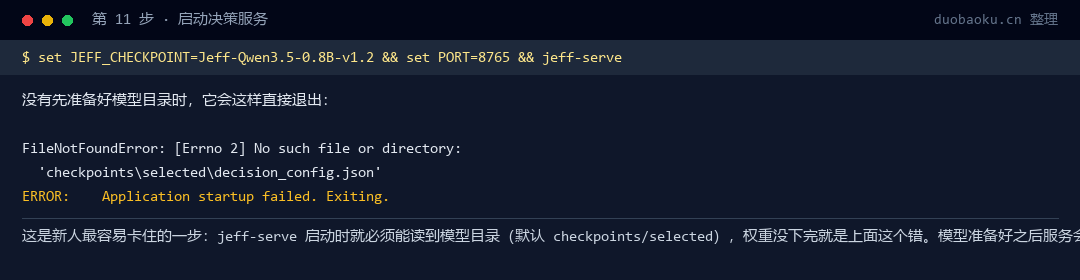
如果报错说找不到 checkpoints/selected/decision_config.json,说明权重没准备好 —— 这是新人最容易卡住的一步,jeff-serve 启动时必须能读到模型目录,没有就立刻退出。
可用的接口:
GET /health—— 健康检查GET /v1/models—— 看当前挂载了哪些适配器POST /v1/systemone—— 发一次决策请求POST /v1/adapters/reload—— 不重启加载新适配器
第 10 步 · 写第一个调用
Python 客户端(pip install . 时已经装上了):
from jeff import Client
from jeff.client import choice_question, yes_no_question

jeff = Client("http://localhost:8765", model="jeff-latest")
answers = jeff.ask("The parcel arrived crushed and I want my money back.", {
    "team": choice_question({
        "refunds": "Refunds and payments",
        "parcels": "Damaged or lost parcels",
        "login": "Account and login problems",
    }, "Which team should handle this ticket?"),
    "angry": yes_no_question("Is the customer angry?"),
})
print(answers.choice("team").key)
想用适配器,就把 model="jeff-latest" 换成 jeff.with_model("guard") 这样。
两条必须遵守的规矩:
1. 选项的 key 永远不要用纯数字。 用 "refunds" 这种描述性短词。纯数字会被前端 JSON 处理悄悄重排。
2. 请求里不变的部分放前面,变化的部分放最后。 这样模型缓存能命中,速度更快。
兼容性说明:Windows 上哪些能用,哪些不能
实测结论(本机 Windows + Python 3.13):
能用的:
jeff-serve决策服务- Python 客户端 / TypeScript 客户端
jeff-kit数据检查全套jeff-evaluate、jeff-decoder、jeff-encoder等推理相关模块
不能用的:
jeff-train训练、jeff-data数据构建这条链路
原因是源码里的 src/jeff/events.py 第 3 行直接 import fcntl,而 fcntl 是 Unix 专有模块,Windows 上不存在。实测 import jeff.train 会直接报:
ModuleNotFoundError: No module named 'fcntl'想在 Windows 上训适配器,用 WSL(Windows 里的 Linux 子系统)就行。
常见问题
Q:为什么会有 ModuleNotFoundError: No module named 'pyarrow'?
pyarrow 属于「训练/评测」那组可选依赖(datasets 的依赖),只装推理依赖时不会有。用到 jeff-grounded、jeff-evaluate 这类命令时补装即可。
Q:跑测试时一堆用例报错,是装坏了吗?
大概率不是。实测 156 个通过,剩下的分三类:① 需要 NVIDIA 显卡的用例(test_cuda_available 之类);② 需要联网下载第三方 tokenizer 的用例(比如 google/gemma-3-270m-it);③ 用了 fcntl 的 Unix 专用用例。都不是安装问题。
Q:CPU 上能跑吗?
能。官方数据是 32 线程 CPU 约 463 毫秒一次决策。做批处理、离线任务没问题;要实时响应还是得有独显。
Q:一定要下载 1.7 GB 权重吗?
是的,jeff-serve 启动时必须能读到模型目录,没有权重它直接退出。这是硬性的。
一句话总结
装 Jeff 的坑总共三个:别装 PyPI 上的同名包、权重下载要设那两个环境变量、启动前先备好模型目录。绕开这三个,剩下的都是等下载。